Strata · Qwen3.8-Flash-Next · Quantvergleich
Nachtlauf 23./24.10.2026 · Ryzen 9 3900X, 96 GB DDR4-3200, RX 7900 XTX 24 GB (Strata/HIP) · IQ3_S · UD-IQ4_XS · UD-Q4_K_XL · Strata 0.1.46.2, MTP spec 4, KV int8
1 · Tempo
strata_bench --long (3 Läufe, Median, Thinking aus, temperature 0). Decode = kurze Chat-Antworten mit MTP; Agent = Folgerunden einer Agent-Sitzung mit wachsendem Kontext. RAM = Zuwachs durch den geladenen Server.
| Quant | Kontext | Laden | Decode | Agent-Decode | Prefill 4K | 16K | 32K | TTFT | Experten im VRAM | RAM | CPU max |
|---|---|---|---|---|---|---|---|---|---|---|---|
| IQ3_S | 128k | 120 s | 61,2 | 63,9 | 1.124 | 1.307 | 1.296 | 0,55 s | 8.416 (16,0 GiB) | 50,1 GiB | 55,4 °C |
| IQ3_S | 256k | 125 s | 59,5 | 66,3 | 1.125 | 1.305 | 1.295 | 0,56 s | 8.297 (15,7 GiB) | 51,9 GiB | 50,9 °C |
| UD-IQ4_XS | 128k | 215 s | 52,3 | 57,4 | 1.034 | 1.201 | 1.193 | 0,68 s | 6.726 (15,2 GiB) | 58,4 GiB | 61,4 °C |
| UD-IQ4_XS | 256k | 236 s | 48,7 | 60,5 | 1.027 | 1.191 | 1.181 | 0,68 s | 6.630 (14,9 GiB) | 60,4 GiB | 50,1 °C |
| UD-Q4_K_XL | 128k | 110 s | 37,5 | 45,1 | 943 | 1.150 | 1.152 | 0,88 s | 5.129 (15,0 GiB) | 75,1 GiB | 55,2 °C |
| UD-Q4_K_XL | 256k | 100 s | 37,1 | 47,0 | 936 | 1.145 | 1.150 | 0,91 s | 5.053 (14,7 GiB) | 76,7 GiB | 50,8 °C |
2 · Langer Kontext
Ein Prompt aus Strata-Doku und -Quelltext, darin drei Notizen mit Zugangscodes bei 15 %, 50 % und 85 % Tiefe; das Modell soll alle drei nennen (Thinking aus). Prefill = Lesetempo des ganzen Prompts, Wartezeit = bis zur fertigen Antwort.
| Quant | Server | Prompt-Tokens | Prefill tok/s | Decode tok/s | Wartezeit | Codes gefunden |
|---|---|---|---|---|---|---|
| IQ3_S | 128k | 30.775 | 1.131 | 53,2 | 28 s | 3/3 |
| IQ3_S | 128k | 63.844 | 1.194 | 62,8 | 54 s | 3/3 |
| IQ3_S | 128k | 120.356 | 1.145 | 61,1 | 106 s | 3/3 |
| IQ3_S | 256k | 172.361 | 1.089 | 47,2 | 160 s | 3/3 |
| IQ3_S | 256k | 250.278 | 1.031 | 56,8 | 228 s | 3/3 |
| UD-IQ4_XS | 128k | 30.775 | 1.089 | 45,4 | 29 s | 3/3 |
| UD-IQ4_XS | 128k | 63.844 | 1.101 | 45,8 | 59 s | 3/3 |
| UD-IQ4_XS | 128k | 120.356 | 1.060 | 53,6 | 115 s | 3/3 |
| UD-IQ4_XS | 256k | 172.361 | 1.013 | 40,9 | 172 s | 3/3 |
| UD-IQ4_XS | 256k | 250.278 | 965 | 49,1 | 244 s | 3/3 |
| UD-Q4_K_XL | 128k | 30.775 | 987 | 32,7 | 33 s | 3/3 |
| UD-Q4_K_XL | 128k | 63.844 | 997 | 35,1 | 65 s | 3/3 |
| UD-Q4_K_XL | 128k | 120.356 | 964 | 43,2 | 126 s | 3/3 |
| UD-Q4_K_XL | 256k | 172.361 | 928 | 32,1 | 188 s | 3/3 |
| UD-Q4_K_XL | 256k | 250.278 | 883 | 35,1 | 267 s | 3/3 |
3 · Python-Aufgaben
12 Aufgaben in vier Stufen, Prompt nennt nur die Spezifikation. Bewertet mit versteckten Tests (Randfälle, Zufallstests gegen eine Referenzlösung, Tempo-Grenzen). Thinking an, temperature 1.0 / top_p 0.95 / top_k 20, bis 32.768 Tokens. Zelle = bestandene Tests je Probe. ↻ = nach Denkschleife wiederholt, ∞ = zweimal Schleife (nicht bestanden).
| Aufgabe | IQ3_S | UD-IQ4_XS | UD-Q4_K_XL |
|---|---|---|---|
| Leicht | |||
| L1 · Lauflängenkodierung | 13/13 13/13 · | 13/13 13/13 13/13 | 13/13 13/13 · |
| L2 · Römische Zahlen | 24/24 24/24 · | 24/24 24/24 24/24 | 24/24 24/24 · |
| L3 · Häufigste Wörter | 9/9 9/9 · | 9/9 9/9 9/9 | 9/9 9/9 · |
| Mittel | |||
| M1 · Intervalle zusammenführen | 21/21 21/21 · | 21/21 21/21 21/21 | 21/21 21/21 · |
| M2 · LRU-Cache | 7/7 7/7 · | 7/7 7/7 7/7 | 7/7 7/7 · |
| M3 · Kursreihenfolge | 11/11 11/11 · | 11/11 11/11 11/11 | 11/11 11/11 · |
| Schwer | |||
| S1 · Ausdrucksauswerter | 46/46 46/46 · | 46/46 46/46 · | 46/46 43/46 · |
| S2 · Labyrinth mit Schlüsseln | 15/15 15/15 · | 15/15 3/15 · | 15/15 3/15 · |
| S3 · Regex-Matcher | 27/27 13/27 · | 27/27 27/27 · | 27/27 27/27 · |
| Hard | |||
| H1 · Mini-Lisp-Interpreter | 34/34 34/34 · | 0/34 30/34 · | 34/34 34/34 · |
| H2 · Minimale Zuordnung | 10/10 10/10 · | 10/10 10/10 · | 10/10 2/10 · |
| H3 · Besondere Zahlen zählen | 11/11 11/11 · | 11/11 5/11 · | 11/11 11/11 · |
| Score je Stufe (Anteil bestandener Tests, gemittelt über Aufgaben und Proben) | |||
| Leicht | 100 % 6/6 voll | 100 % 9/9 voll | 100 % 6/6 voll |
| Mittel | 100 % 6/6 voll | 100 % 9/9 voll | 100 % 6/6 voll |
| Schwer | 91 % 5/6 voll | 87 % 5/6 voll | 86 % 4/6 voll |
| Hard | 100 % 6/6 voll | 72 % 3/6 voll | 87 % 5/6 voll |
| Gesamt | 98 % 23/24 voll | 92 % 26/30 voll | 93 % 21/24 voll |
| Denk-Tokens im Schnitt | 13.419 | 14.531 | 14.501 |
4 · WebGL: Schwarzes Loch
Aufgabe: eine einzelne HTML-Datei, WebGL ohne Bibliotheken, animiert, wie das Referenzbild. Screenshots nach 1,5 s in Chromium (RX 7900 XTX über ANGLE/Vulkan). „animiert“ = zwei Bilder im Abstand von 2 s unterscheiden sich. Klick auf ein Bild öffnet die echte Seite.
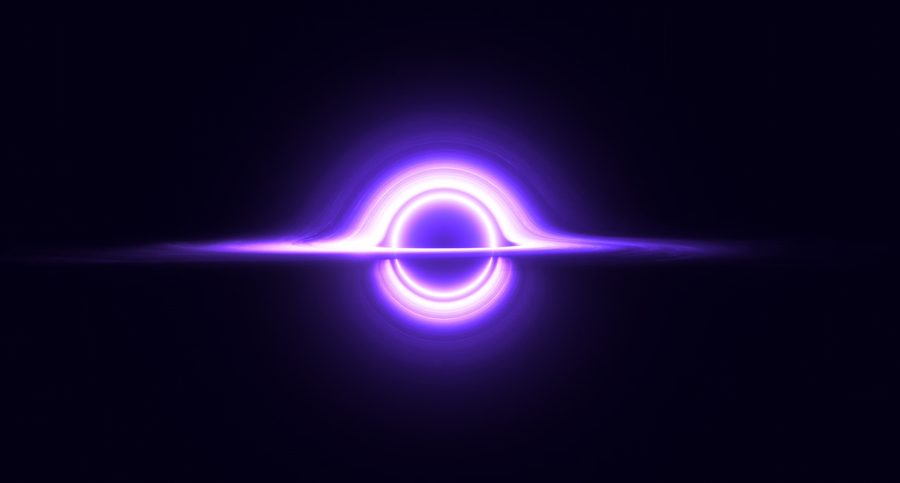
IQ3_S
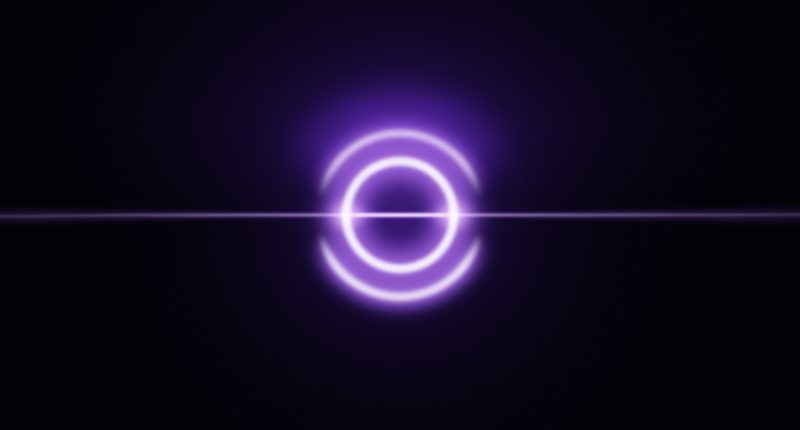
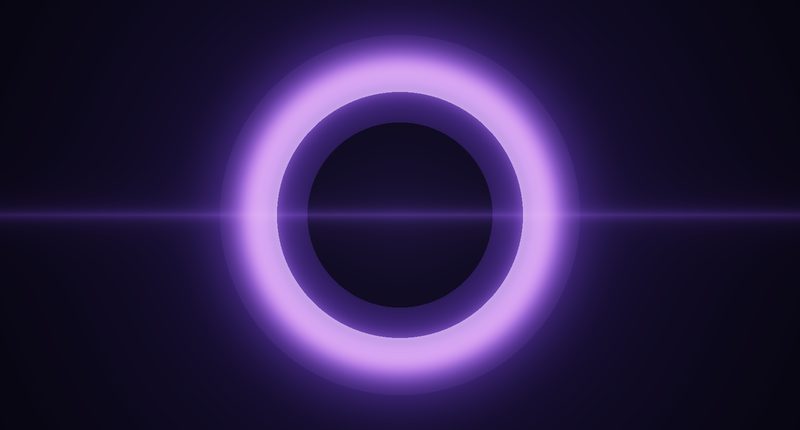
UD-IQ4_XS
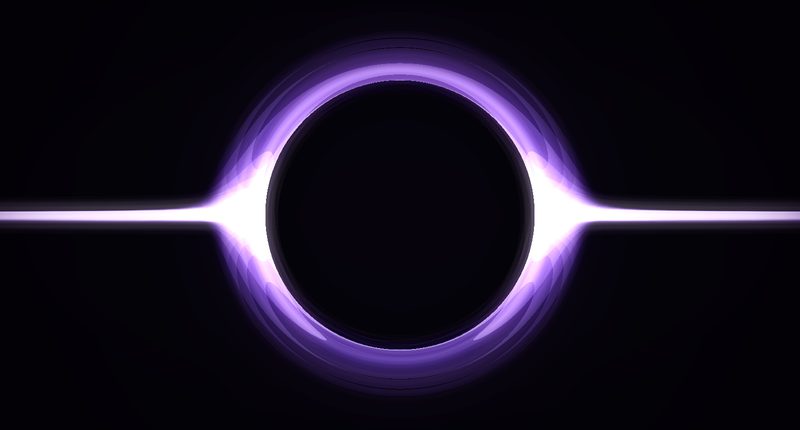
UD-Q4_K_XL
12096 Tokens · 258 s · Seite öffnen
14102 Tokens · 294 s · Seite öffnen
5 · Weblayout nach Bild + DESIGN.md
System-Prompt = image-to-code-Skill, dazu 8 Bildausschnitte der 1920 × 11.926 px großen Vorlage und die DESIGN.md (Sternen-Shadow-Zeilen gekürzt, sonst unverändert). Ganzseiten-Screenshot bei 1920 px Breite, verkleinert; im Kasten scrollen. Klick öffnet die echte Seite.
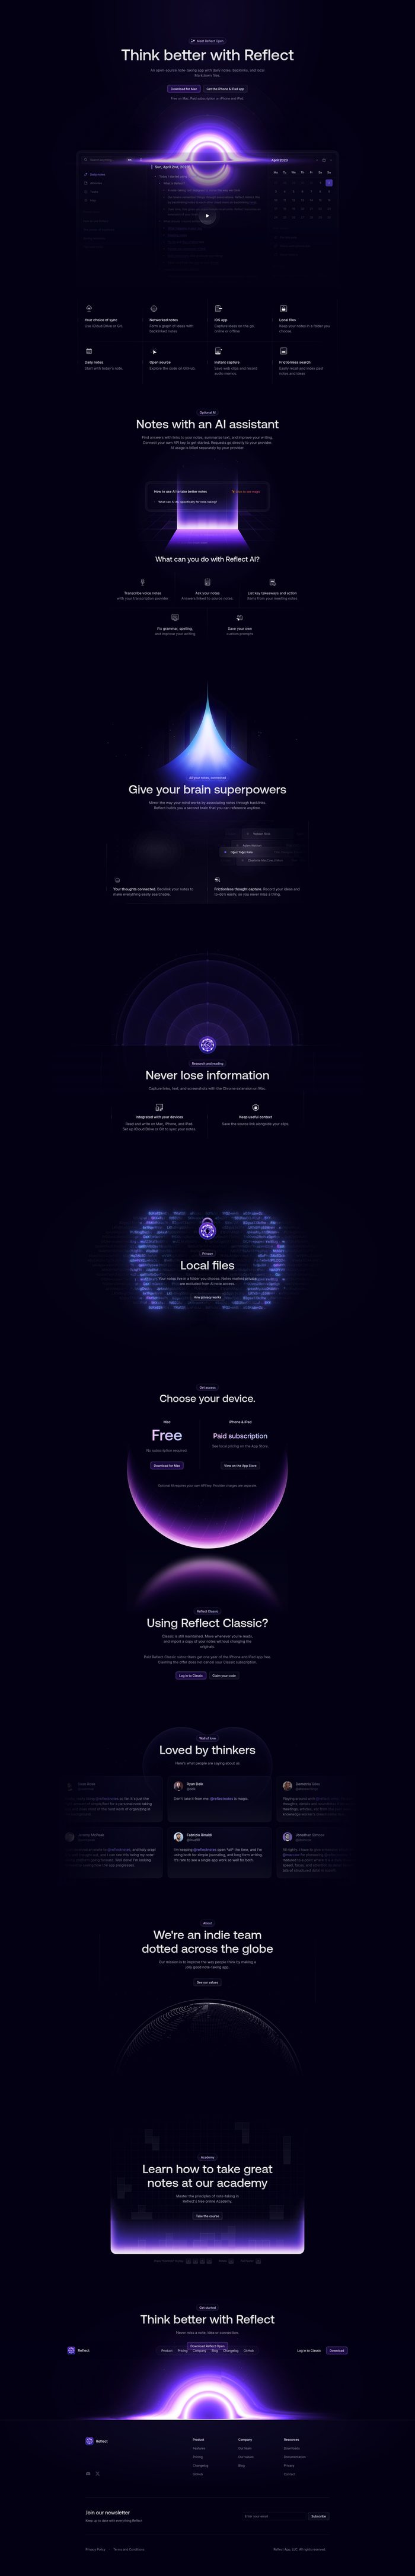
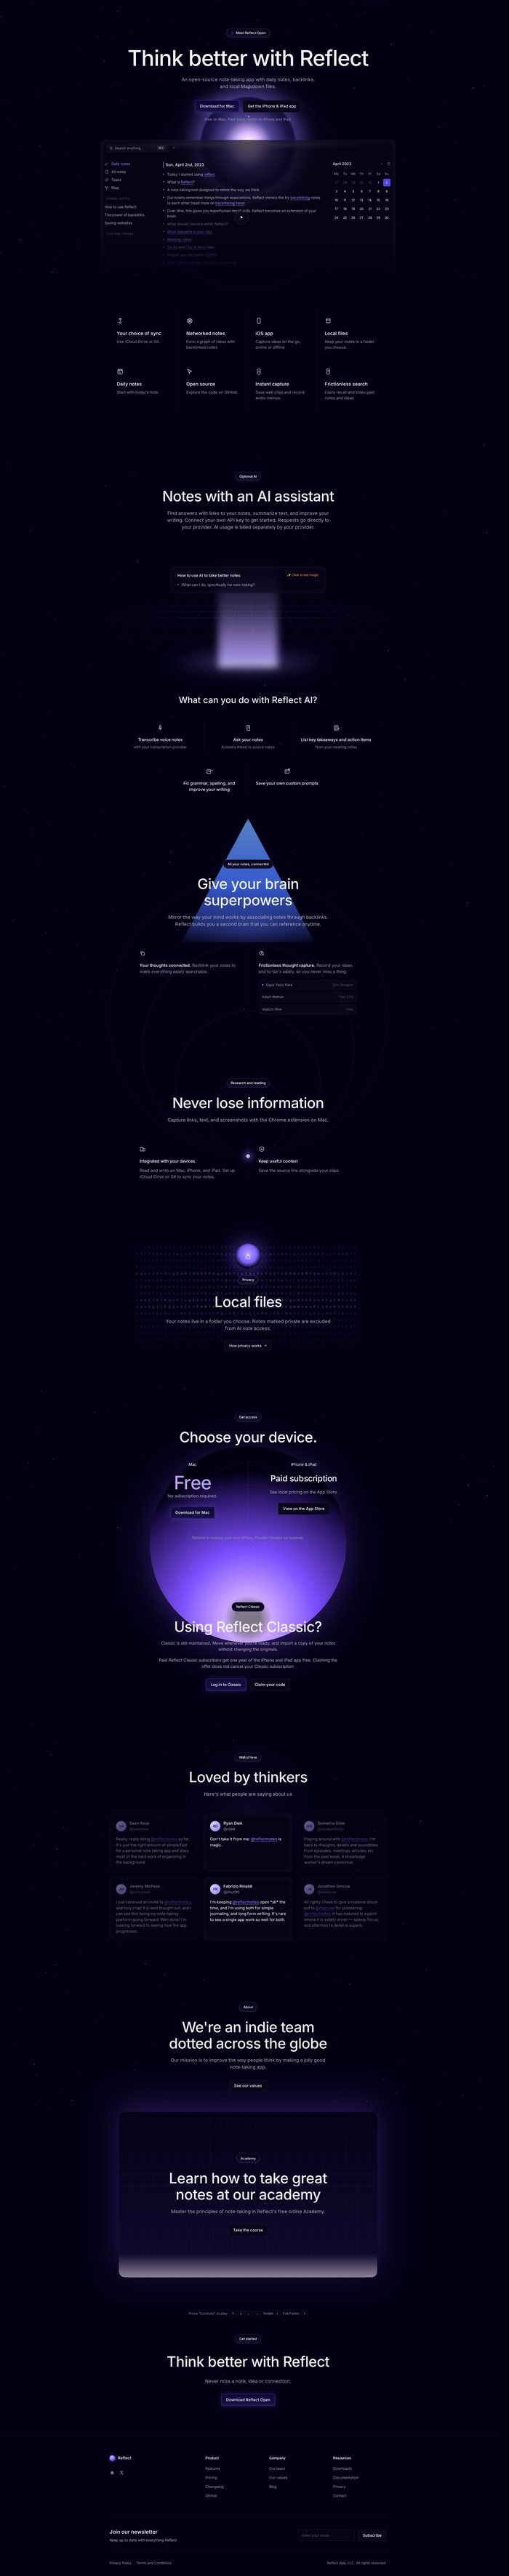
24610 Tokens · 351 s · 9.973 px hoch · Seite öffnen
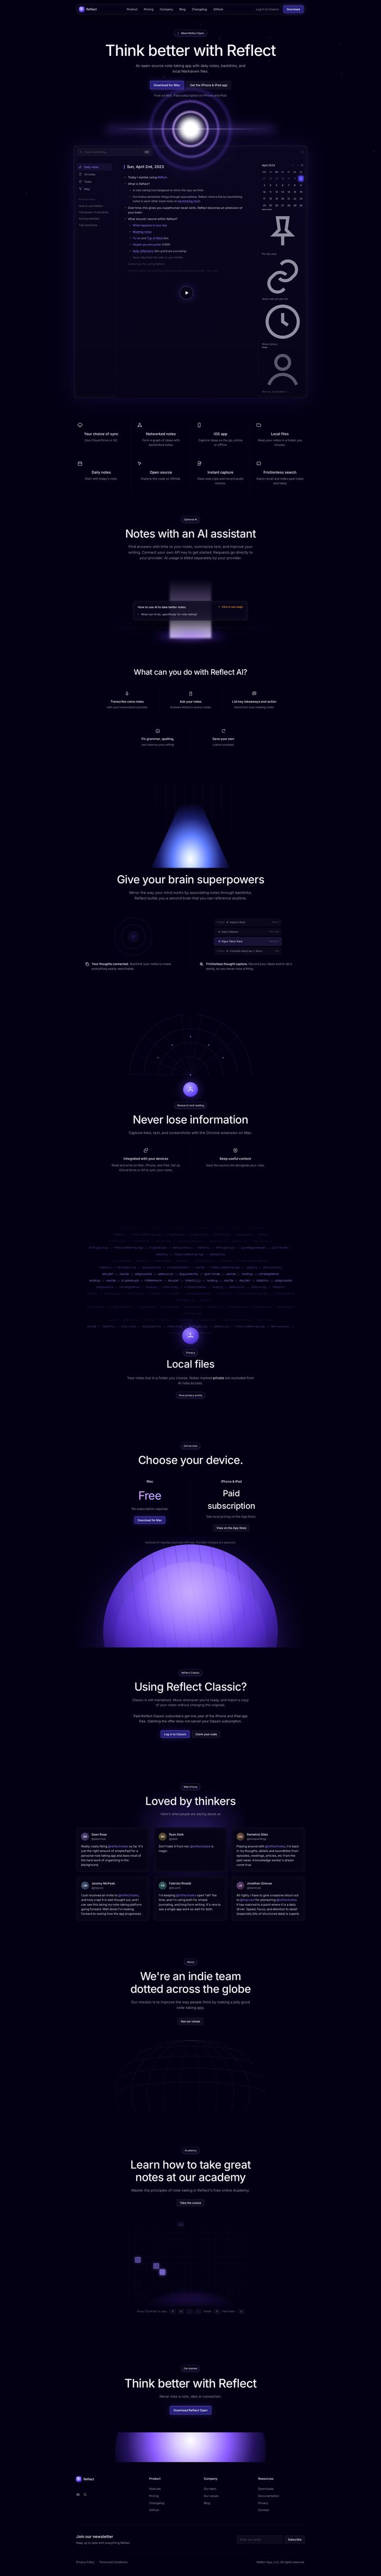
35188 Tokens · 599 s · 13.000 px hoch · Seite öffnen
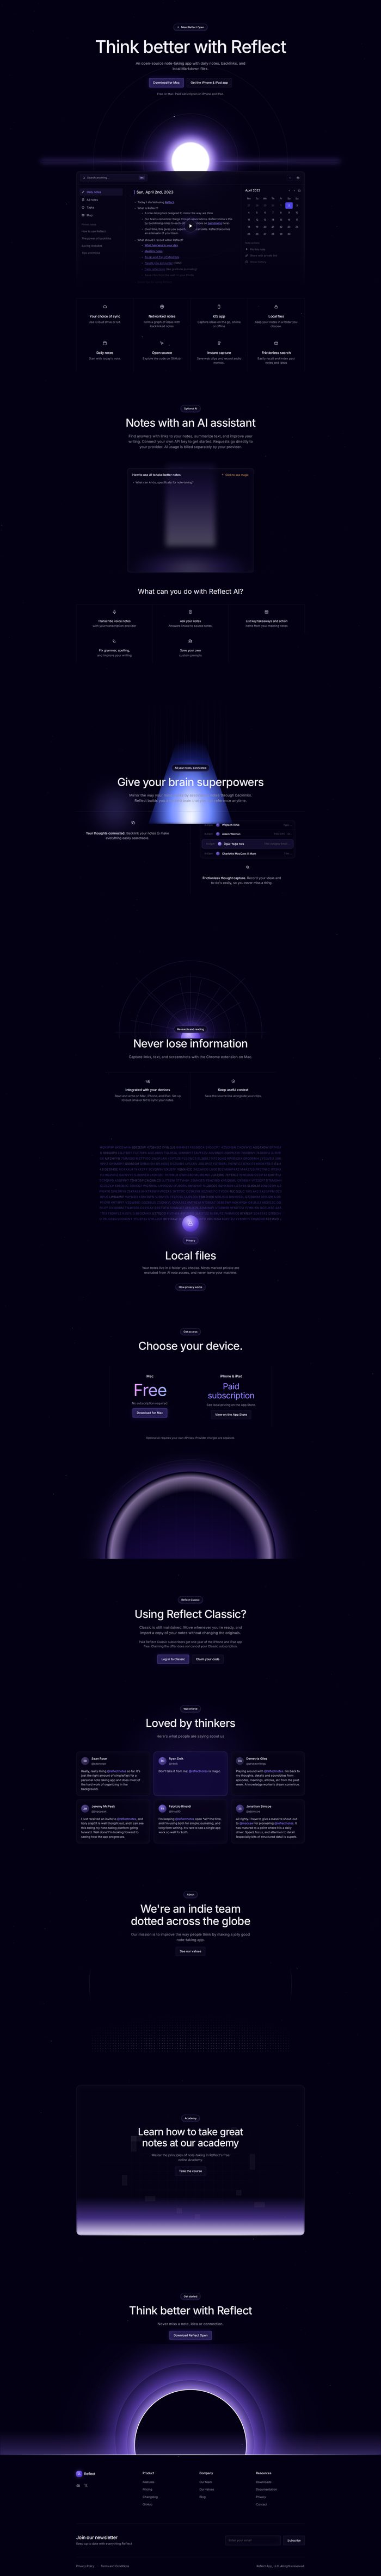
34384 Tokens · 743 s · 12.998 px hoch · Seite öffnen
4b · WebGL und Layout mit Werkzeugen
Gleiche Aufgaben, aber das Modell arbeitet in einem Arbeitsordner mit Werkzeugen: Dateien schreiben/ändern/lesen und die Seite in Chromium öffnen (Konsole, JS-Fehler, eigener Testcode, Screenshots, die es selbst ansieht). Höchstens 40 Werkzeugaufrufe bzw. 2 h je Probe; jede Werkzeugantwort nennt die verbleibenden Aufrufe, ab 5 mit der Bitte, die Seite fertigzustellen. Bewertet wird die index.html am Ende, mit denselben Screenshots wie oben.
Schwarzes Loch
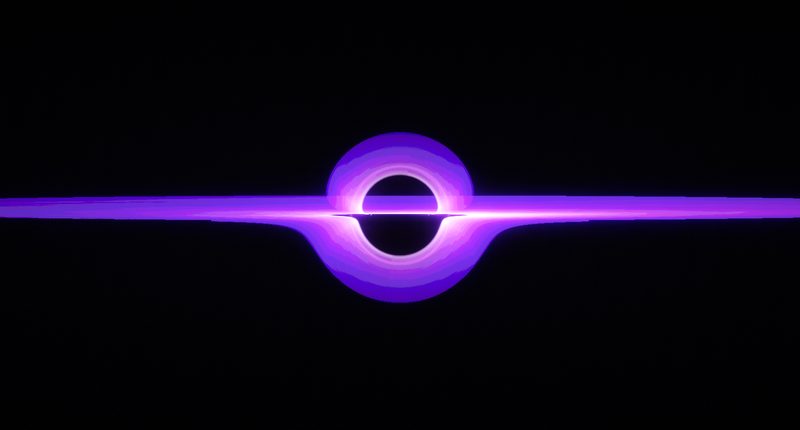
30 Aufrufe (2× schreiben, 15× ändern, 13× Browser, 12 Screenshots) · 68.858 Tokens · 22 min · Ende: budget · Seite öffnen
30 Aufrufe (2× schreiben, 17× ändern, 10× Browser, 7 Screenshots) · 53.736 Tokens · 17 min · Ende: budget · Seite öffnen
Layout
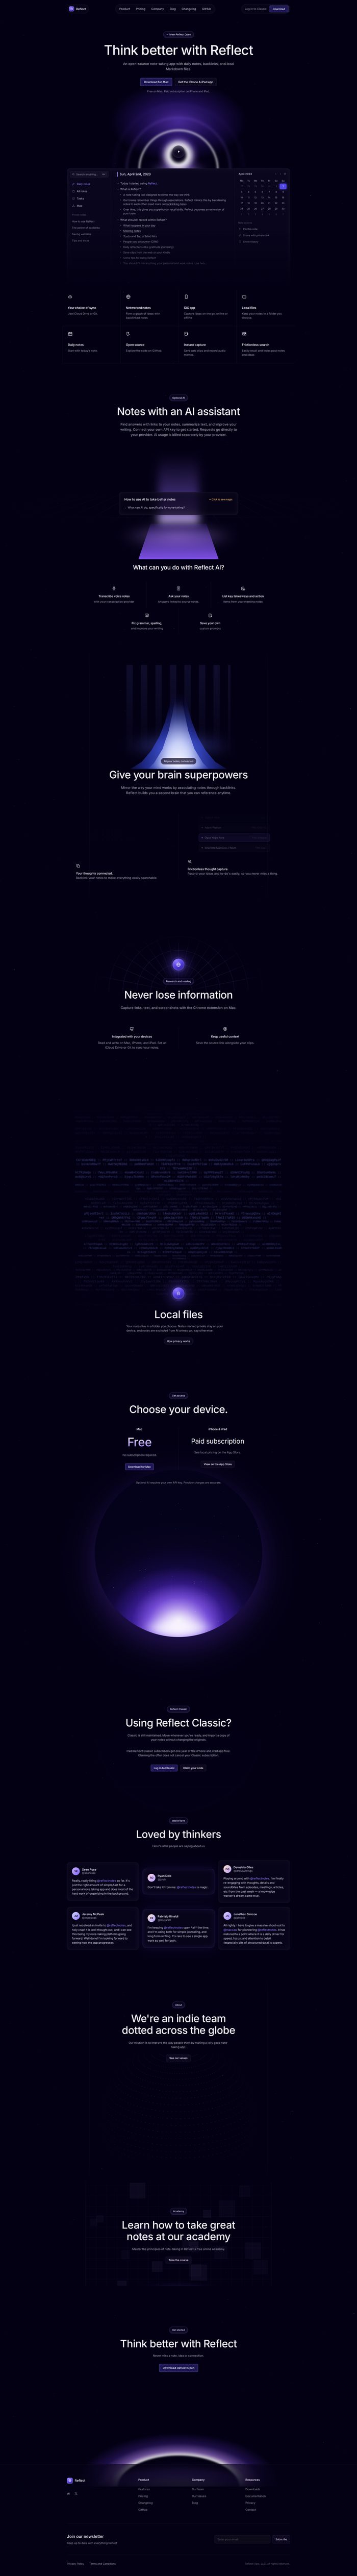
18 Aufrufe (1× schreiben, 4× ändern, 12× Browser, 12 Screenshots) · 40.665 Tokens · 15 min · Ende: finish · Seite öffnen
6 · RTX 3060: Gemma 4 + Qwen Image 2.1 parallel
Gemma 4 E4B Q4_K_M (llama.cpp, 98K Kontext, Vision) als Dienst auf Port 8092, dazu ComfyUI mit Qwen Image 2.1 (int8_convrot-UNet, Qwen3-VL-8B-int8-Textencoder, 1024 × 1024, 25 Schritte, euler) auf derselben 12-GB-Karte.
Ergebnis: geht, aber erst mit PyTorch cu130. Mit der alten ComfyUI-Umgebung (.venv, PyTorch 2.6 + cu124, noch für die GTX 1070
eingerichtet) schaltet ComfyUI die CUDA-Kernel von comfy-kitchen ab („You need pytorch with cu130“), rechnet int8 über den Eager-Fallback und
läuft neben Gemma in allen drei Versuchen sofort in einen Out-of-Memory. Mit einer neuen Umgebung ~/comfy/ComfyUI/.venv-cu130
(PyTorch 2.14.1 + cu130, Treiber 580 unterstützt CUDA 13.0) laufen alle Bilder durch.
VRAM-Spitze 11.892 MiB von 12.288 (allein 11.562 MiB) – ComfyUI lädt das Modell teilweise und lagert den Rest dynamisch in den RAM aus, deshalb kostet die Koexistenz mit Gemma (≈ 5,5 GB) nur rund 10 % Bildzeit. Laufen beide wirklich gleichzeitig, teilen sie sich die Rechenleistung: das Bild braucht ~60 s statt 42 s, Gemma fällt von ~75 auf ~27 tok/s und ist danach sofort wieder bei 74 tok/s. Der Gemma-Dienst lief die ganze Zeit stabil weiter, keine Abstürze. GPU-Temperatur max. 77 °C, 168 W.
Nebenbei behoben: llama.cpp war nur für die GTX 1070 (sm_61) gebaut, Gemma stürzte auf der 3060 in einer Schleife ab
(„no kernel image is available“). Neu gebaut mit CMAKE_CUDA_ARCHITECTURES=86, alte Binärdateien in
~/src/llama.cpp-bin-sm61-backup. Gemma läuft jetzt mit ~75 tok/s. Während dieser Messung lief auf der XTX parallel Strata (Phase C).
Methode und Einschränkungen
Rohdaten: ~/src/Strata2-data/quant-test/results/ · erzeugt mit make_report.py